LeRobot入门教程 10:LeRobot 策略推理
1. 从「随机乱动」到「会干活」
上一册机械臂在乱戳,因为动作是随机采样的。这一册换成真正训练过的策略模型。
用的模型是 lerobot/pi0_libero_finetuned——π0 是 Physical Intelligence 提出的视觉-语言-动作(VLA)模型,把「看画面 + 读指令」直接映射成「下一步动作」。Hub 上这个权重是在 LIBERO 数据上微调过的版本。
VLA 和普通图像分类模型的区别:
| 普通模型 | VLA 策略 | |
|---|---|---|
| 输入 | 一张图 | 图像 + 机器人状态 + 语言指令 |
| 输出 | 类别 | 动作序列(action chunk) |
| 使用方式 | 单次前向 | 闭环:观察 → 出动作 → 执行 → 再观察 |
2. 三段式:模型、策略侧处理器、环境侧适配器
LeRobot 把「模型」和「数据搬运」拆开了。一次推理要串起三个东西:
| 组件 | 创建方式 | 负责什么 |
|---|---|---|
| 策略模型 | make_policy(cfg, env_cfg=...) | 真正的神经网络,输入张量、输出动作 |
| 策略侧预处理/后处理 | make_pre_post_processors(cfg, ...) | 归一化、图像缩放、动作反归一化(un-normalize) |
| 环境侧适配器 | make_env_pre_post_processors(...) | 把仿真环境给的数据格式变成策略要的格式,再把动作变回环境能吃的格式 |
3. 加载模型和环境
import torch
from lerobot.envs import make_env, make_env_pre_post_processors, preprocess_observation
from lerobot.envs.configs import LiberoEnv
from lerobot.policies import make_policy, make_pre_post_processors
from lerobot.configs.policies import PreTrainedConfig
from lerobot.utils.constants import ACTION

MODEL = "lerobot/pi0_libero_finetuned"
env_cfg = LiberoEnv(task="libero_spatial", task_ids=[0], observation_height=256, observation_width=256)
env = list(list(make_env(env_cfg, n_envs=1).values())[0].values())[0]
cfg = PreTrainedConfig.from_pretrained(MODEL)
cfg.pretrained_path = MODEL
cfg.device = "cuda"
policy = make_policy(cfg, env_cfg=env_cfg).eval()
pre, post = make_pre_post_processors(cfg, pretrained_path=MODEL,
                                     preprocessor_overrides={"device_processor": {"device": "cuda"}})
env_pre, env_post = make_env_pre_post_processors(env_cfg=env_cfg, policy_cfg=cfg)
Creating LIBERO envs | suites=['libero_spatial'] | n_envs(per task)=1 | init_states=True
Restricting to task_ids=[0]
[info] using task orders [0, 1, 2, 3, 4, 5, 6, 7, 8, 9]
Built vec env | suite=libero_spatial | task_id=0 | n_envs=1
The PI0 model is a direct port of the OpenPI implementation.
This implementation follows the original OpenPI structure for compatibility.
Original implementation: https://github.com/Physical-Intelligence/openpi
Loading model from: lerobot/pi0_libero_finetuned
stderr:
WARNING:root:Vision embedding key might need handling: model.paligemma_with_expert.paligemma.model.vision_tower.vision_model.embeddings.patch_embedding.bias
stderr:
WARNING:root:Vision embedding key might need handling: model.paligemma_with_expert.paligemma.model.vision_tower.vision_model.embeddings.patch_embedding.weight
✓ Loaded state dict from model.safetensors
All keys loaded successfully!
几个关键行:
PreTrainedConfig.from_pretrained(MODEL)读的是 Hub 上的config.json,它决定模型结构(层数、动作维度、图像尺寸),结构必须和权重匹配;cfg.pretrained_path = MODEL告诉后续加载去这里找权重文件;cfg.device = "cuda",同时preprocessor_overrides={"device_processor": {"device": "cuda"}}让预处理也把张量搬到 GPU——两处都要设,只设一处会导致张量在 CPU/GPU 之间来回拷;.eval()切到推理模式,关掉 dropout 之类的训练期行为;make_env_pre_post_processors(env_cfg=env_cfg, policy_cfg=cfg)需要两边的信息:环境提供字段名和形状,策略提供归一化统计量。
输出里那两行 WARNING: Vision embedding key might need handling 是加载视觉主干时的提示,末尾的 All keys loaded successfully! 才是结论——权重全部加载成功。
4. 闭环推理:一次观察换一个动作
obs, info = env.reset()
frames = []
for _ in range(20):
    o = preprocess_observation(obs)
    o["task"] = list(env.call("task_description"))
    o = pre(env_pre(o))
    with torch.inference_mode():
        a = post(policy.select_action(o))
    obs, r, *_ = env.step(env_post({ACTION: a})[ACTION].cpu().numpy())
    frames.append(obs["pixels"]["image"][0][::-1].copy())
show(frames)
env.close()
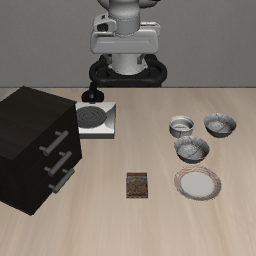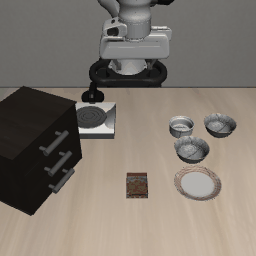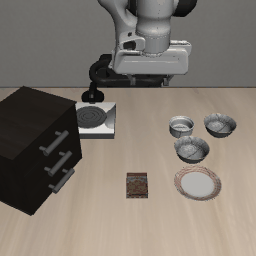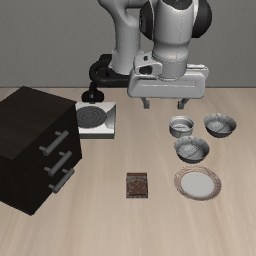
5. 把数据流拆开看
这一格是全套教程里信息密度最高的一段,逐行拆:
env.reset()                    → obs(仿真原始格式)
   ↓ preprocess_observation(obs)   → 统一的键名/布局
   ↓ o["task"] = ...               → 补上语言指令(策略的输入之一)
   ↓ env_pre(o)                    → 环境侧适配(形状、归一化)
   ↓ pre(o)                        → 策略侧预处理(图像缩放、设备搬运)
   ↓ policy.select_action(o)       → 神经网络前向
   ↓ post(a)                       → 动作反归一化
   ↓ env_post({ACTION: a})[ACTION] → 变回环境能执行的格式
   ↓ env.step(...)                 → 机械臂动一步
几个容易忽略的点:
| 细节 | 说明 |
|---|---|
o["task"] = list(env.call("task_description")) | 指令必须喂给策略。少了这一行,模型不知道要干什么,动作会退化成无意义抖动 |
torch.inference_mode() | 比 no_grad() 更彻底地关掉梯度记录,省显存也更快。推理一律用它 |
post(policy.select_action(o)) | 模型原始输出是归一化空间里的动作,post 负责映射回真实控制量。漏掉 post 机械臂会疯动 |
env_post(...)[ACTION].cpu().numpy() | 仿真只吃 numpy,张量留在 GPU 上会报错,所以 .cpu() |
for _ in range(20) | 只跑 20 步是为了出 GIF;真实评测要跑到 episode 结束(见 11 册《评测》) |
跑完会看到机械臂朝杯子方向移动,明显比上一册的随机乱动「有目的」——但 20 步通常做不完整个任务,所以画面不会出现「任务完成」。
6. 常见问题
| 现象 | 原因 | 处理 |
|---|---|---|
CUDA out of memory | π0 较大,显存吃紧;或没关环境 | 先 env.close(),再确认没有别的进程占卡;必要时用小 batch |
| 机械臂动作剧烈抖动 | 漏了 post() 反归一化 | 检查是否写成 policy.select_action(o) 直接 env.step |
| 模型完全不响应指令 | 漏了 o["task"] | 补上 task_description |
| 加载很慢/卡住 | 没走加速通道 | 回 07 册《环境与网络》 |
shape mismatch | 环境分辨率和模型训练分辨率不一致 | 保持 observation_height=256 |