LeRobot入门教程 14:LeRobot RoboMeter 奖励模型
1. 为什么需要奖励模型
强化学习需要一个「打分」信号:这一步动作让任务完成度前进了多少。仿真里可以读环境给的真值,真机上没有真值——没人告诉你「杯子已经被抓起来了」。
奖励模型(reward model)就是学一个「看画面 + 读指令 → 预估进度」的模型,代替人工打分。这是真机强化学习能跑起来的前提。
2. RoboMeter 是什么
lerobot/Robometer-4B 是 LeRobot 内置的零样本奖励模型:
| 项 | 值 |
|---|---|
| 底座 | Qwen/Qwen3-VL-4B-Instruct(视觉语言模型) |
| 输入 | 最近若干帧画面 + 语言指令 |
| 输出 | progress(0→1 的完成度)或 success(是否完成) |
默认 max_frames | 8(只看最近 8 帧) |
默认 success_threshold | 0.5 |
| 精度 | bfloat16 |
为什么只取最近 8 帧:4B 视觉模型吃不下整条轨迹全部帧,显存和时间都不允许。用滑动窗口看最近一段,足够判断「现在进行到哪」。代价是:如果任务中途「倒退」(杯子又被碰掉了),进度会跟着掉——这其实是好事,说明它看的是当前状态而不是累加历史。
3. 准备:先把策略和环境装回来
下面这段和 10 册《策略推理》里的加载代码一模一样。为了让本册能独立运行,这里再执行一次——如果你刚跑完 10 册同一个 kernel,这段可以跳过。
import torch
from lerobot.envs import make_env, make_env_pre_post_processors, preprocess_observation
from lerobot.envs.configs import LiberoEnv
from lerobot.policies import make_policy, make_pre_post_processors
from lerobot.configs.policies import PreTrainedConfig
from lerobot.utils.constants import ACTION

MODEL = "lerobot/pi0_libero_finetuned"
env_cfg = LiberoEnv(task="libero_spatial", task_ids=[0], observation_height=256, observation_width=256)
env = list(list(make_env(env_cfg, n_envs=1).values())[0].values())[0]
cfg = PreTrainedConfig.from_pretrained(MODEL)
cfg.pretrained_path = MODEL
cfg.device = "cuda"
policy = make_policy(cfg, env_cfg=env_cfg).eval()
pre, post = make_pre_post_processors(cfg, pretrained_path=MODEL,
                                     preprocessor_overrides={"device_processor": {"device": "cuda"}})
env_pre, env_post = make_env_pre_post_processors(env_cfg=env_cfg, policy_cfg=cfg)
print("策略与环境已就绪")
4. 跑一段轨迹并逐帧打分
import numpy as np, torch
from lerobot.envs import make_env, preprocess_observation
from lerobot.utils.constants import ACTION
from lerobot.rewards.robometer import (
    RobometerConfig, RobometerRewardModel, make_robometer_pre_post_processors,
)

env = list(list(make_env(env_cfg, n_envs=1).values())[0].values())[0]
obs, info = env.reset()
task = env.call("task_description")[0]
frames = []
for _ in range(20):
    o = preprocess_observation(obs)
    o["task"] = list(env.call("task_description"))
    o = pre(env_pre(o))
    with torch.inference_mode():
        a = post(policy.select_action(o))
    obs, r, *_ = env.step(env_post({ACTION: a})[ACTION].cpu().numpy())
    frames.append(torch.from_numpy(obs["pixels"]["image"][0][::-1].copy()))
env.close()

REPO = "lerobot/Robometer-4B"
rcfg = RobometerConfig(device="cuda", pretrained_path=REPO)
rpre, _ = make_robometer_pre_post_processors(rcfg)
rmodel = RobometerRewardModel.from_pretrained(REPO, config=rcfg).to("cuda").eval()

progress = []
for t in range(1, len(frames) + 1):
    seq = torch.stack(frames[max(0, t - rcfg.max_frames):t]).permute(0, 3, 1, 2).unsqueeze(0)
    batch = rpre({rcfg.image_key: seq, rcfg.task_key: task})
    with torch.inference_mode():
        progress.append(float(rmodel.compute_reward(batch)[0]))
print("progress:", [round(p, 3) for p in progress])
Creating LIBERO envs | suites=['libero_spatial'] | n_envs(per task)=1 | init_states=True
Restricting to task_ids=[0]
[info] using task orders [0, 1, 2, 3, 4, 5, 6, 7, 8, 9]
Built vec env | suite=libero_spatial | task_id=0 | n_envs=1
stderr:
Kwargs passed to `processor.__call__` have to be in `processor_kwargs` dict, not in `**kwargs`
stderr:
/root/miniconda3/lib/python3.12/site-packages/transformers/tokenization_utils_base.py:2341: UserWarning: `max_length` is ignored when `padding`=`True` and there is no truncation strategy. To pad to max length, use `padding='max_length'`.
  warnings.warn(
Kwargs passed to `processor.__call__` have to be in `processor_kwargs` dict, not in `**kwargs`
stderr:
Kwargs passed to `processor.__call__` have to be in `processor_kwargs` dict, not in `**kwargs`
stderr:
Kwargs passed to `processor.__call__` have to be in `processor_kwargs` dict, not in `**kwargs`
stderr:
Kwargs passed to `processor.__call__` have to be in `processor_kwargs` dict, not in `**kwargs`
stderr:
Kwargs passed to `processor.__call__` have to be in `processor_kwargs` dict, not in `**kwargs`
stderr:
Kwargs passed to `processor.__call__` have to be in `processor_kwargs` dict, not in `**kwargs`
stderr:
Kwargs passed to `processor.__call__` have to be in `processor_kwargs` dict, not in `**kwargs`
stderr:
Kwargs passed to `processor.__call__` have to be in `processor_kwargs` dict, not in `**kwargs`
stderr:
Kwargs passed to `processor.__call__` have to be in `processor_kwargs` dict, not in `**kwargs`
stderr:
Kwargs passed to `processor.__call__` have to be in `processor_kwargs` dict, not in `**kwargs`
stderr:
Kwargs passed to `processor.__call__` have to be in `processor_kwargs` dict, not in `**kwargs`
stderr:
Kwargs passed to `processor.__call__` have to be in `processor_kwargs` dict, not in `**kwargs`
stderr:
Kwargs passed to `processor.__call__` have to be in `processor_kwargs` dict, not in `**kwargs`
stderr:
Kwargs passed to `processor.__call__` have to be in `processor_kwargs` dict, not in `**kwargs`
stderr:
Kwargs passed to `processor.__call__` have to be in `processor_kwargs` dict, not in `**kwargs`
stderr:
Kwargs passed to `processor.__call__` have to be in `processor_kwargs` dict, not in `**kwargs`
stderr:
Kwargs passed to `processor.__call__` have to be in `processor_kwargs` dict, not in `**kwargs`
stderr:
Kwargs passed to `processor.__call__` have to be in `processor_kwargs` dict, not in `**kwargs`
stderr:
Kwargs passed to `processor.__call__` have to be in `processor_kwargs` dict, not in `**kwargs`
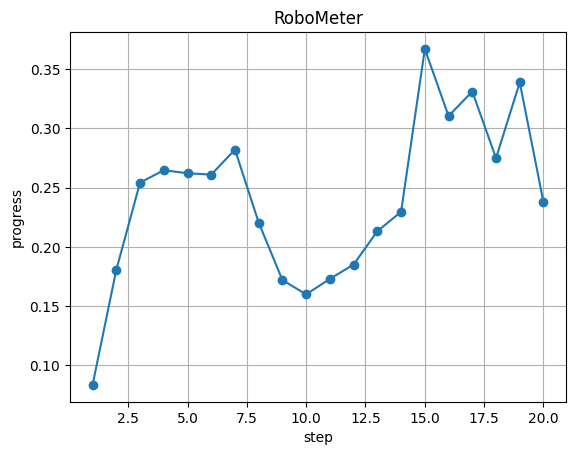
progress: [0.083, 0.181, 0.254, 0.265, 0.262, 0.261, 0.282, 0.22, 0.172, 0.16, 0.173, 0.185, 0.213, 0.23, 0.367, 0.311, 0.331, 0.275, 0.339, 0.238]
5. 把进度画成曲线
import matplotlib.pyplot as plt
plt.plot(range(1, len(progress) + 1), progress, marker="o")
plt.xlabel("step")
plt.ylabel("progress")
plt.title("RoboMeter")
plt.grid(True)
plt.show()
6. 逐段拆开看
第一段:跑 20 步,把画面存成张量而不是 numpy 数组。
frames.append(torch.from_numpy(obs["pixels"]["image"][0][::-1].copy()))
注意 [::-1] 又出现了——奖励模型看到的画面方向要和它训练时一致,所以这里也要翻转。.copy() 必须加:切片是视图,不复制的话 20 帧会全指向最后一块内存。
第二段:加载奖励模型。
REPO = "lerobot/Robometer-4B"
rcfg = RobometerConfig(device="cuda", pretrained_path=REPO)
rpre, _ = make_robometer_pre_post_processors(rcfg)
rmodel = RobometerRewardModel.from_pretrained(REPO, config=rcfg).to("cuda").eval()
和策略模型一样是「配置 + 预处理器 + 模型」三件套。rpre 负责把图像序列和指令打包成模型要的格式。
第三段:滑动窗口打分。
for t in range(1, len(frames) + 1):
    seq = torch.stack(frames[max(0, t - rcfg.max_frames):t]).permute(0, 3, 1, 2).unsqueeze(0)
    batch = rpre({rcfg.image_key: seq, rcfg.task_key: task})
    progress.append(float(rmodel.compute_reward(batch)[0]))
| 步骤 | 作用 |
|---|---|
frames[max(0, t - 8):t] | 取最近 8 帧;前几帧不够 8 个就从头截,max(0, ...) 防止负索引 |
.permute(0, 3, 1, 2) | 把帧序列从 [T,H,W,C] 变成 [T,C,H,W],视觉模型要通道在前 |
.unsqueeze(0) | 加 batch 维,变成 [1,T,C,H,W] |
rpre({...}) | 缩放、归一化、拼上语言指令 |
compute_reward(batch)[0] | 取第一个样本的分数,即当前进度 |
7. 结果怎么读
本例输出:
progress: [0.083, 0.181, 0.254, 0.265, 0.262, 0.261, 0.282, 0.22, 0.172, 0.16,
           0.173, 0.185, 0.213, 0.23, 0.367, 0.311, 0.331, 0.275, 0.339, 0.238]
这是随机初始状态下的结果,不值得当结论读,但能看出三件事:
- 起始值 0.083 不是 0——模型认为「刚开始也有一点点进度」,这是零样本奖励模型的通病,做 RL 时通常要减掉基线;
- 从 0.08 爬到 0.37 再掉回 0.24:20 步内机械臂大致朝目标靠近过,但后来偏离了;
- 波动幅度 ±0.1 很大,说明单帧判断噪声不小,实际用的时候要对多帧做平滑(滑动平均)。
这正说明为什么奖励模型要谨慎用:它是「估计」不是「真值」。真正跑 RL 之前,先在已知成功/失败的轨迹上验证它的分数排序对不对。
8. 常见问题
| 现象 | 原因 | 处理 |
|---|---|---|
| 加载 RoboMeter 时显存不够 | 4B bf16 约 8 GB,还要和策略模型共存 | 先 del policy / 清 cache,或分两个 kernel 跑 |
一堆 Kwargs passed to processor.__call__ | transformers 新版的参数约定提示 | 无害 |
| 分数始终在 0.1 附近 | 画面方向或分辨率不对 | 确认 [::-1] 和 256×256 |
| 分数饱和在 1.0 | 用了 success 而不是 progress,或任务已完成 | 检查 rcfg.reward_output |