LeRobot入门教程 08:LeRobot 数据集
1. LeRobot 数据格式长什么样
LeRobot 的 v3.0 数据集不是一个文件,而是一个目录。以本册要用的 lerobot/libero 为例(数据来自服务器上的 meta/info.json):
| 字段 | 值 | 含义 |
|---|---|---|
codebase_version | v3.0 | 数据格式版本 |
robot_type | panda | 采集用的机械臂:Franka Panda |
total_episodes | 1693 | 演示条数 |
total_frames | 273465 | 总帧数 |
total_tasks | 40 | 不同语言指令数 |
fps | 10.0 | 记录帧率 |
chunks_size | 1000 | 每 1000 条 episode 一个数据块目录 |
一帧里有这些字段:
| 特征 | 类型 | 形状 | 说明 |
|---|---|---|---|
observation.images.image | video | [256, 256, 3] | 第三人称相机 agentview |
observation.images.image2 | video | [256, 256, 3] | 腕部相机 eye_in_hand |
observation.state | float32 | [8] | 机器人本体状态(末端位姿 + 夹爪) |
action | float32 | [7] | 控制量:3 维平移 + 3 维旋转 + 1 维夹爪 |
timestamp / frame_index / episode_index / task_index | — | [1] | 时间与索引 |
理解一个 episode:从机器人视角看,一条 episode 就是「人拖动机器人(或遥操作)做完一件事」的完整过程,帧与帧之间隔 1/fps 秒。语言指令 task 是这件事的自然语言描述。
为什么两个相机:agentview 看全局(桌子、盘子、杯子都在画面里),eye_in_hand 看细节(夹爪离目标多近)。策略模型一般两路都吃。
2. 加载数据集
LeRobotDataset("lerobot/libero") 里的字符串叫 repo_id,格式是 用户名/数据集名,对应 Hub 上的 https://huggingface.co/datasets/lerobot/libero。第一次调用会下载并缓存到 ~/.cache/huggingface(本机实际缓存目录在 /autodl-fs/data/huggingface/lerobot/hub),之后再加载就是读本地。
from lerobot.datasets.lerobot_dataset import LeRobotDataset

ds = LeRobotDataset("lerobot/libero")
print(ds.num_episodes, "episodes,", ds.num_frames, "frames, fps", ds.fps)
sample = ds[100]
print(sample["task"])
Downloading bytes: | 0.00B
Reconstructing (incomplete total...): | | 0.00B / 0.00B
Fetching 4 files: 0%| | 0/4 [00:00<?, ?it/s]
1693 episodes, 273465 frames, fps 10.0
put the white mug on the left plate and put the yellow and white mug on the right plate
3. 输出在读什么
1693 episodes, 273465 frames, fps 10.0
put the white mug on the left plate and put the yellow and white mug on the right plate
1693 episodes:1693 条演示。后面训练时一个 batch 抽的是帧,不是 episode;273465 frames:平均一条 episode 约 161 帧,也就是 16 秒左右——长任务和短任务混在一起,所以平均意义不大;ds[100]:取第 100 帧。注意索引是全局帧号,不是「第几条 episode 的第几帧」,跨 episode 的边界要自己用episode_index判断;sample["task"]:这一帧对应的语言指令。整条 episode 内指令不变。
一条帧样本是个字典,除了 task 还有 observation.images.image、observation.images.image2、observation.state、action 等键。图像张量的布局是 CHW(通道在前),这是 PyTorch 的习惯;而 matplotlib 要的是 HWC,所以下一格要 permute(1, 2, 0)。
4. 看一眼两路相机的画面
import matplotlib.pyplot as plt
plt.figure(figsize=(8, 4))
for i, k in enumerate(["observation.images.image", "observation.images.image2"]):
    plt.subplot(1, 2, i + 1)
    plt.imshow(sample[k].permute(1, 2, 0).numpy())
    plt.axis("off")
plt.show()
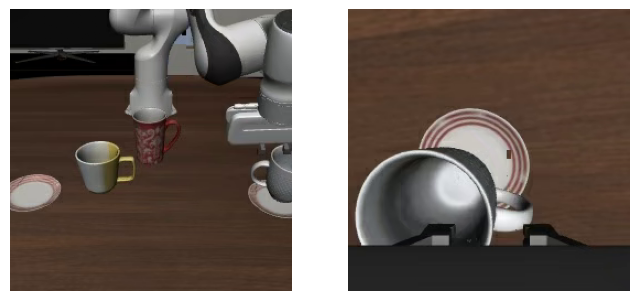
左图是第三人称视角 agentview,右图是腕部视角 eye_in_hand。
sample[k] 的形状是 [3, 256, 256],permute(1, 2, 0) 之后变成 [256, 256, 3] 才交给 imshow。